
En bref
- J’ai confié à Claude Fable 5.2 (effort high) et à Claude Opus 5.5 (effort max) la même app Angular 22 à construire, deux fois : d’abord les fonctionnalités, puis une refonte visuelle. Sur un benchmark public de programmation, les deux obtiennent le même score.
- Mes tests cachés n’ont pas pu les départager : 50 réussis, 1 échoué, 9 ignorés, pour les deux modèles, dans les deux manches. Chacun a échoué à un test différent.
- La facture, si. Les deux manches ont coûté environ $60 et 107 minutes avec Fable high, environ $90 et 167 minutes avec Opus max, au prix catalogue... alors qu’un token Fable coûte deux fois plus cher.
- Les deux ont écrit de l’Angular moderne : pas de
NgModule, pas d’inputs par décorateur, pas de*ngIf. Quelques vieilles habitudes sont restées, le polling en direct reste unsubscribeRxJS géré à la main dans chaque app, et ce qui distinguait les deux a changé d’une exécution à l’autre. - Mon choix pour ce type de travail est Fable high : le même score, un code du même niveau, environ deux tiers du temps et de l’argent. Et mesurer a été plus difficile que construire... mes propres tests se sont trompés six fois, et mon isolation a échoué trois fois.
Mon outil de tous les jours est Claude Fable, et Angular est mon terrain de prédilection ; je m’y sens chez moi. Il y a quelque temps, j’ai vu un graphique de benchmark où Fable 5.2 en effort high et Opus 5.5 en effort max obtiennent presque le même score, 45.3% et 45.5%, alors qu’Opus coûte environ deux fois plus cher par tâche. Le même score sur un benchmark de programmation généraliste... mais cela tient-il sur le genre de travail que je fais réellement ? Je voulais le voir de mes propres yeux, sur Angular 22. Il est sorti en juin et se situe tout au bord de ce que ces modèles connaissent.
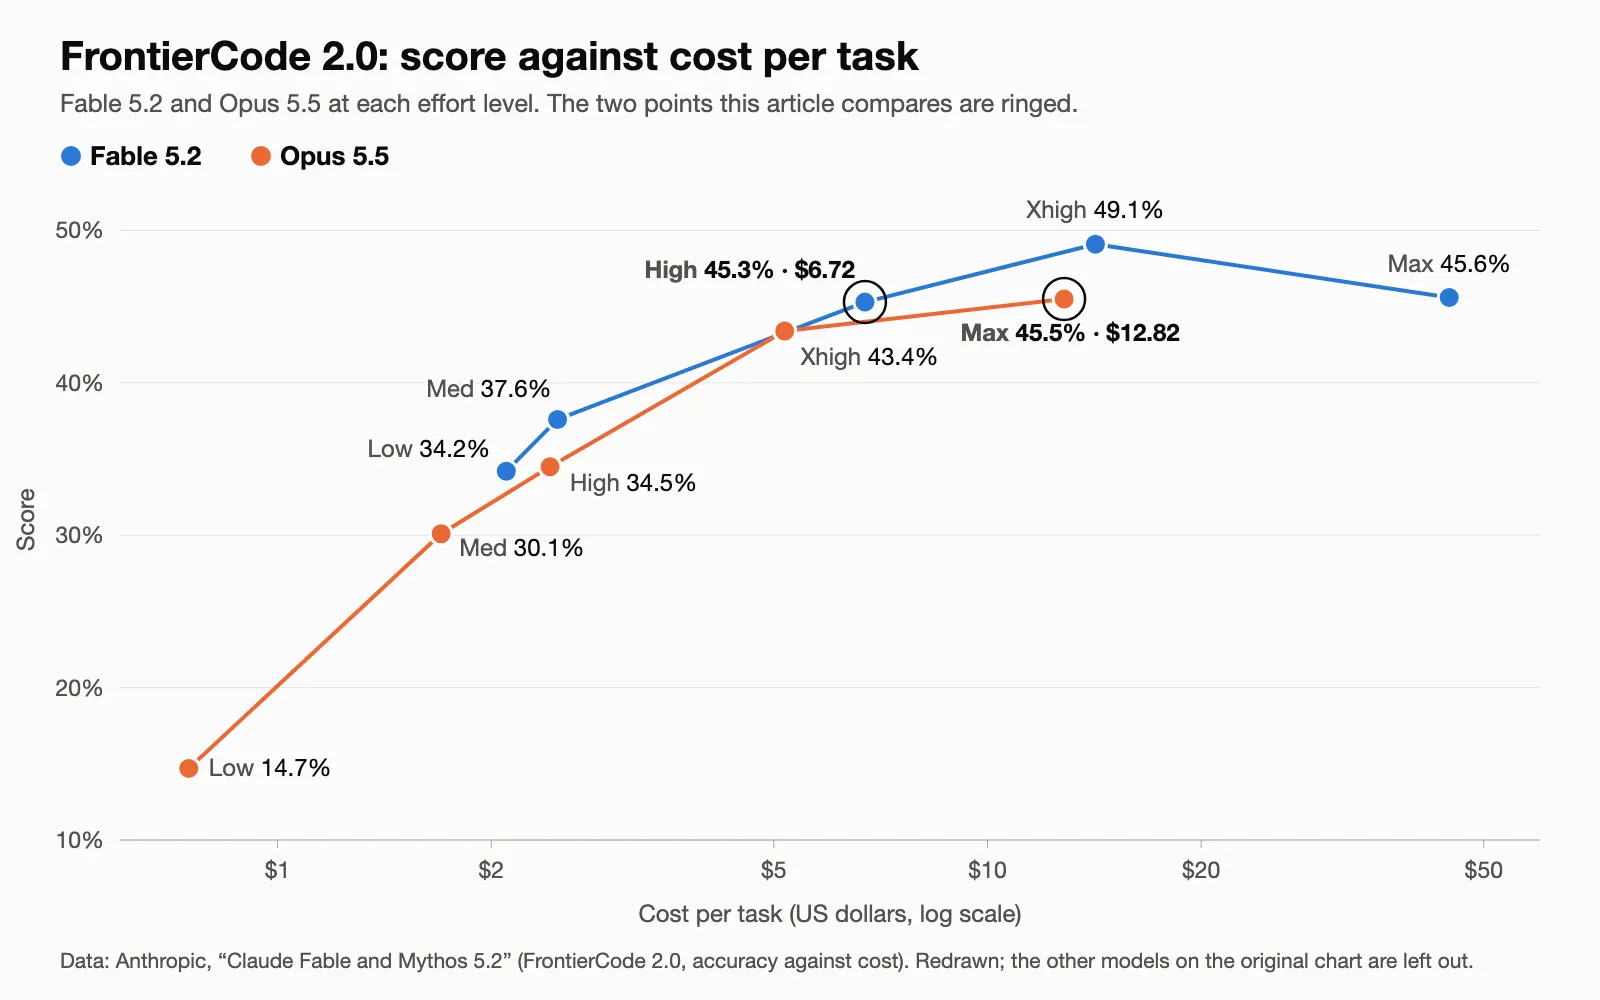
FrontierCode 2.0, redessiné à partir du graphique d’Anthropic avec seulement ces deux modèles. Les deux points entourés sont la paire que compare cet article.
La démo ci-dessus est l’app Fable max de la manche 2, qui tourne dans votre navigateur sans aucun serveur derrière. Elle s’ouvre quelques secondes avant un but. Appuyez sur Restart pour regarder le match depuis le coup d’envoi, revenez en arrière sur la frise ou passez à l’autre match. Quatre choses diffèrent de ce que le modèle a livré : j’ai retiré l’outil de composition d’équipe, ajouté la barre de relecture en haut, adouci l’élargissement du mot GOAL et ajouté le thème clair ; le design propre au modèle est le sombre. La démo contient deux des quatre matchs.
#La configuration
Les deux configurations
Chiffres du benchmark lus sur le graphique FrontierCode 2.0 ; prix catalogue par million de tokens.
| Fable 5.2 | Opus 5.5 | |
|---|---|---|
| Effort | high | max |
| Score au benchmark | 45.3% | 45.5% |
| Coût par tâche au benchmark | $6.72 | $12.82 |
| Prix catalogue, entrée / sortie | $8 / $40 | $4 / $20 |
La tâche est un centre de match en direct. Un petit serveur local rejoue quatre matchs de football enregistrés comme s’ils étaient en direct, et l’app doit afficher une liste de matchs, une vue de match en direct avec un terrain et un fil d’événements, des panneaux de statistiques, un formulaire de composition d’équipe et un outil qui compare deux moments du flux. Quinze exigences, trois extras. Le cahier des charges ne nomme pas une seule fonctionnalité d’Angular.
Les deux modèles ont reçu le même aide-mémoire : la skill Angular officielle et le serveur MCP de la CLI Angular. C’était voulu... je voulais voir où ils le suivent, où ils s’en écartent et ce qu’ils inventent.
Chaque exécution partait de zéro : son propre dossier sandbox, Claude Code 2.1.322, et rien de moi dedans. Ma configuration globale restait à l’écart, donc aucun fichier d’instructions à moi et aucune mémoire de sessions antérieures. Je l’ai vérifié dans le journal de chaque session au lancement : le bon modèle et le bon niveau d’effort, zéro fichier d’instructions chargé, un dossier de mémoire vide et le prompt de départ exactement comme prévu. (Dans le pilote, mon fichier global s’est bel et bien infiltré ; j’y reviens plus bas.) La paire propre a tourné le 13 novembre 2026 pour la manche 1 et le 16 novembre pour la manche 2.
Chaque exécution comptait deux manches. Chaque manche était une nouvelle session avec un seul prompt tapé et personne pour répondre aux questions :
- Manche 1 : construire ce que décrit le cahier des charges.
- Manche 2 : donner à l’app sa propre identité et au moins trois moments « wow » (un but, les données qui se corrigent, et leurs propres idées), sans rien casser de la manche 1.
Ce que j’ai mesuré :
- 60 tests de navigateur cachés que les modèles n’ont jamais vus, exécutés sur une copie de chaque app terminée.
- Une analyse statique du code au regard de la skill Angular, 33 lignes, avec les occurrences vérifiées à la main.
- Les transcriptions des sessions : temps, tokens, appels d’outils, prompts tapés.
- Des lecteurs de code à l’aveugle, un par app, avec les mêmes instructions et sans noms de modèles : deux sur la paire propre, puis trois sur les apps finales, Fable max compris.
J’ai d’abord lancé une paire pilote, puis une paire propre avec une configuration figée, puis une exécution supplémentaire avec Fable en max. Les chiffres ci-dessous viennent de la paire propre, sauf mention contraire. C’est la seule paire dont la notation a fait l’objet d’une relecture indépendante.
#Les données étaient un meilleur piège que tout ce que j’aurais pu inventer
Les données des matchs viennent d’un vrai fournisseur, et les vraies données en direct se corrigent d’elles-mêmes. Dans un match, le flux arrive sous forme de 145 instantanés complets. Entre le premier et le dernier, 93 événements disparaissent à nouveau, dont 4 tirs, et 679 événements changent de position. Dans un autre match, un but contre son camp arrive comme une paire d’événements à part, si bien que si vous comptez les buts naïvement, vous obtenez 1–1 alors que le vrai score est 1–2.
Je n’ai pas eu à concevoir la difficulté. Il m’a suffi de mesurer ce qui était déjà là et de demander à l’app de le montrer : un marqueur « corrected », des compteurs et une vue qui survit à la réécriture du flux.
#Ce que disent les tests
Les quatre instantanés de la paire propre (deux modèles, deux manches) se sont tous terminés de la même façon : 50 réussis, 1 échoué, 9 ignorés. Les 9 tests ignorés sont les mêmes partout ; le cahier des charges ne leur donne rien de mesurable à quoi se raccrocher.
Lisez ce chiffre avec attention. Il ne dit pas que les deux apps se valent. Il dit que ma suite est à son plafond et ne peut pas les départager. Ce qu’elle peut dire, c’est quel test chacune a raté, et c’est là que ça devient intéressant :
- Fable high perd le joueur sélectionné quand l’autre équipe fait un remplacement. Je l’ai reproduit à la main : à une étape, la sélection est là, à la suivante elle a disparu, alors que le joueur sélectionné est toujours sur le terrain.
- Opus max met en évidence le joueur en train d’agir, mais seulement quand l’événement le plus récent a un joueur. Sur 117 des 339 étapes de jeu (34.5%), personne n’est mis en évidence. Le cahier des charges peut se lire dans les deux sens, donc je compte cela comme un manque partiel, pas comme un bug.
Aucune des manches 2 n’a corrigé ni cassé quoi que ce soit de visible pour les tests.
Le bug de Fable est mon morceau de code préféré de toute l’expérience, parce que les deux apps sont entrées dans la même pièce. Les deux ont construit la liste des effectifs sur la nouvelle listbox d’Angular Aria, une liste par équipe. Opus ne donne à chaque liste que la valeur de sa propre équipe et laisse un commentaire qui explique pourquoi. Fable donne la même valeur aux deux listes. Quand une liste se réordonne après un remplacement, elle abandonne l’id qu’elle ne connaît pas et signale une sélection vide, et l’app l’enregistre comme « rien de sélectionné ». Même brique, même après-midi... une exécution a vu le piège, l’autre non. Les 101 tests de Fable sont restés verts tout du long.
Une autre différence mesurée : pendant 30 mises à jour en direct, l’app de Fable en manche 2 a produit de 13 à 16 tâches longues sur le thread principal sur trois répétitions, la plus longue de 171 ms. Opus n’en a produit aucune. Je vous préviens, les deux apps sont servies différemment par leurs propres scripts de démarrage, donc ce n’est pas uniquement le code.
#Ce que dit la facture
Manche 1 : temps, tokens et coût
D’après les transcriptions des sessions de la paire propre, au prix catalogue.
| Fable high | Opus max | |
|---|---|---|
| Temps réel (minutes) | 48.8 | 75.7 |
| Messages API | 99 | 227 |
| Tokens de sortie | 251k | 403k |
| Entrée en cache relue | 31M | 98M |
| Coût au prix catalogue | $23.17 | $32.76 |
| Prompts tapés | 1 | 1 |
Manche 2 : temps, tokens et coût
Mêmes sources. Opus max a aussi lancé son propre agent de relecture, compté dans son coût.
| Fable high | Opus max | |
|---|---|---|
| Temps réel (minutes) | 58.6 | 91.5 |
| Messages API | 167 | 334 + 107 dans son propre agent de relecture |
| Tokens de sortie | 309k | 515k |
| Entrée en cache relue | 71M | 196M |
| Coût au prix catalogue | $36.50 | $57.37 |
| Prompts tapés | 1 | 2 |
Les deux manches ensemble : Fable high $59.67 et 107 minutes, Opus max $90.13 et 167 minutes. Les exécutions sont passées par un abonnement, donc les dollars sont des estimations au prix catalogue.
Un token Fable coûte deux fois plus cher qu’un token Opus, et Fable est pourtant revenu environ un tiers moins cher. La raison n’est pas la sortie. En effort max, Opus a fait plus de deux fois plus d’appels, et chaque appel relit toute la conversation jusque-là. L’entrée en cache est bon marché par token, mais à 196 millions de tokens elle devient la plus grosse ligne de la facture.
Soyons honnêtes sur le chronomètre :
- La manche 1 a tourné pendant un incident réseau de mon côté. Les deux sessions ont réessayé en silence pendant quelques minutes. Une fois cela déduit, Fable est à environ 43 minutes et Opus entre 68 et 74.
- En manche 2, Opus a perdu sa connexion une fois et j’ai tapé
continue. C’est le deuxième prompt tapé du tableau. - Opus a aussi lancé de lui-même un agent de relecture en manche 2, l’a attendu 18 minutes et a corrigé les 8 points qu’il a trouvés. Personne ne l’avait demandé. Je compte l’attente dans son temps et l’agent dans son coût... et je pense aussi que c’était une bonne décision.
#Comment ils ont utilisé Angular 22
La question sur laquelle je pensais écrire était « qui écrit encore du vieil Angular ». La réponse : personne. Pas d’inputs par décorateur, pas de NgModule, pas de *ngIf, pas d’injection par constructeur, pas de zone. Opus a gardé trois vieilles habitudes sans conséquence : @Injectable() à 3 endroits, OnPush écrit explicitement 17 fois alors que c’est désormais le défaut, et le withFetch() déprécié.
Le noyau moderne est le même dans les deux apps : signal forms, httpResource, @defer avec @boundary autour des panneaux, view transitions, paramètres de route en inputs. Les deux ont ignoré les mêmes API plus récentes, dont resource(), injectAsync() et debounced(). (Fable en max, plus bas, a bien utilisé resource() et rxResource.)
Puis la surprise : dans le pilote, Fable traitait le flux dans un web worker et Opus non. Fable ignorait Angular Aria et Opus l’utilisait. Dans la paire propre, c’était l’inverse, sur chacun de ces points. Ce sont donc des choix qui changent d’une exécution à l’autre, et j’ai cessé d’écrire des phrases qui commencent par « Fable fait » ou « Opus fait ». Avec une exécution par modèle, vous regardez un seul lancer de dés.
Deux choses se sont répétées dans les deux paires : Opus découpe le travail en davantage de services, et Fable en high fait grossir un store central unique (704 lignes dans le pilote, 883 dans l’exécution propre). Même cela n’est pas un trait du modèle... en effort max, Fable a découpé le même travail en deux classes plus petites et étanches.
L’aide-mémoire lui-même était faux à un endroit. La skill recommande une valeur de --ai-config que la CLI n’accepte plus. Fable a suivi la skill et s’est fait rejeter, dans les deux paires. Opus a d’abord lu ng new --help, dans les deux paires. S’écarter de l’aide-mémoire était ici la bonne décision, et un seul des deux l’a prise.
#L’apparence
La manche 1 a produit deux tableaux de bord gris. Ça, c’est de ma faute : le cahier des charges comptait quinze exigences fonctionnelles et pas un mot sur le design, et les deux modèles ont optimisé ce que je mesure.
La manche 2 demandait une identité, et voici ce qui s’est passé : à cinq secondes d’intervalle, dans des sandboxes séparées, avant d’avoir partagé quoi que ce soit, les deux ont noté le même concept et le même nom. « Floodlit » : un match de nuit sous les projecteurs, avec un tableau d’affichage à matrice de points. Opus a mis le nom dans son en-tête. Fable l’a gardé pour son README et a écrit « Under the lights » sur la page, comme vous pouvez le voir sur les captures ci-dessous. Le texte de la tâche dit « broadcast ». Il ne parle ni de nuit ni de projecteurs. Dans le pilote aussi, les deux avaient choisi un stade de nuit sous les projecteurs, et Fable en max plus tard également. Cinq refontes, cinq matchs de nuit sous les projecteurs.
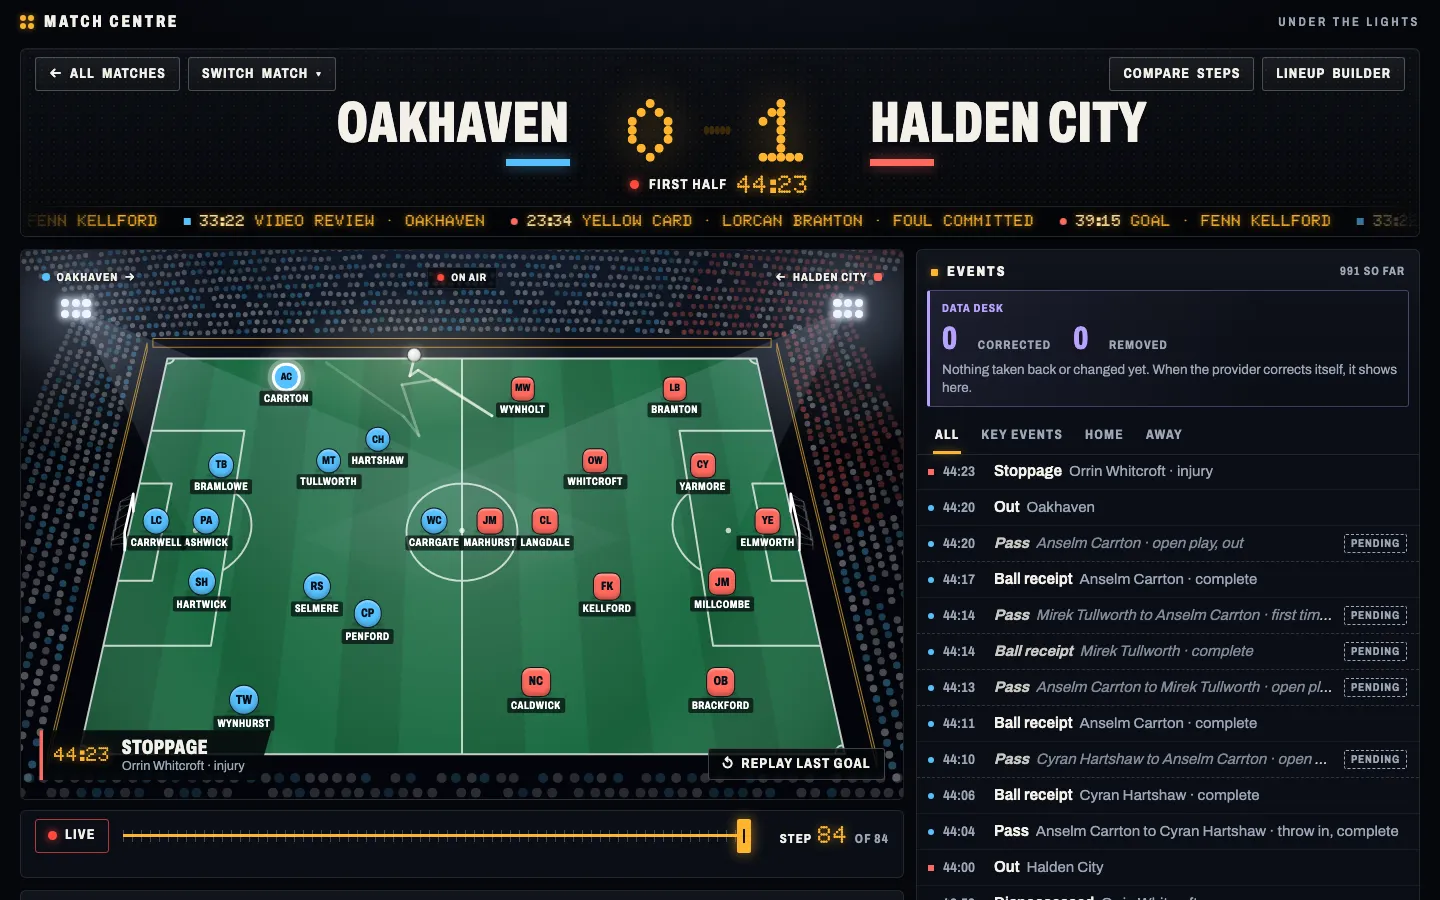
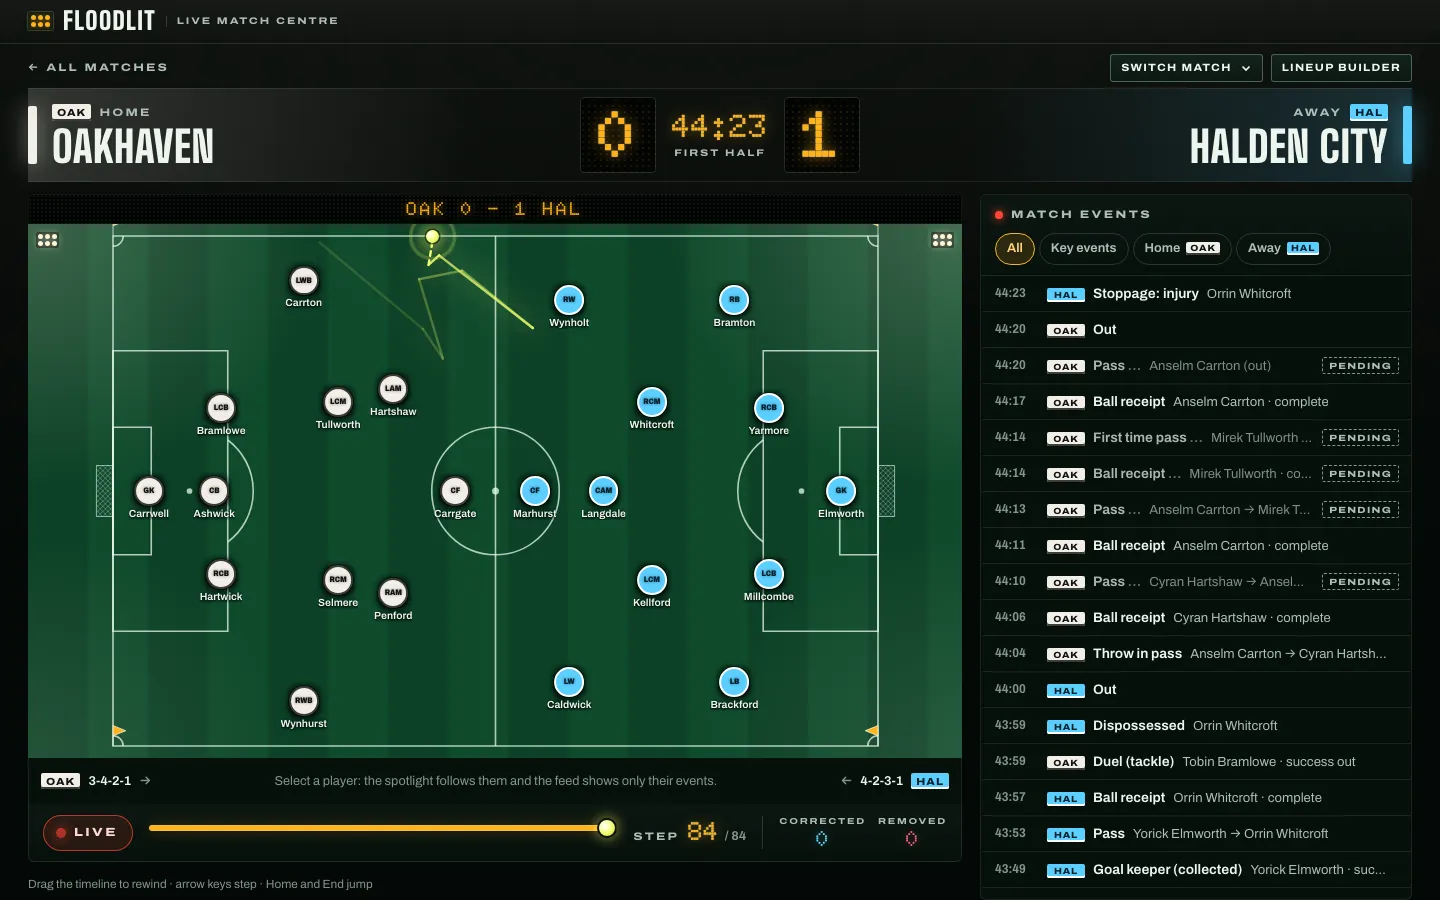
Fable high, puis Opus max : manche 2, le même moment du même match. Les noms des équipes et des joueurs sont inventés.
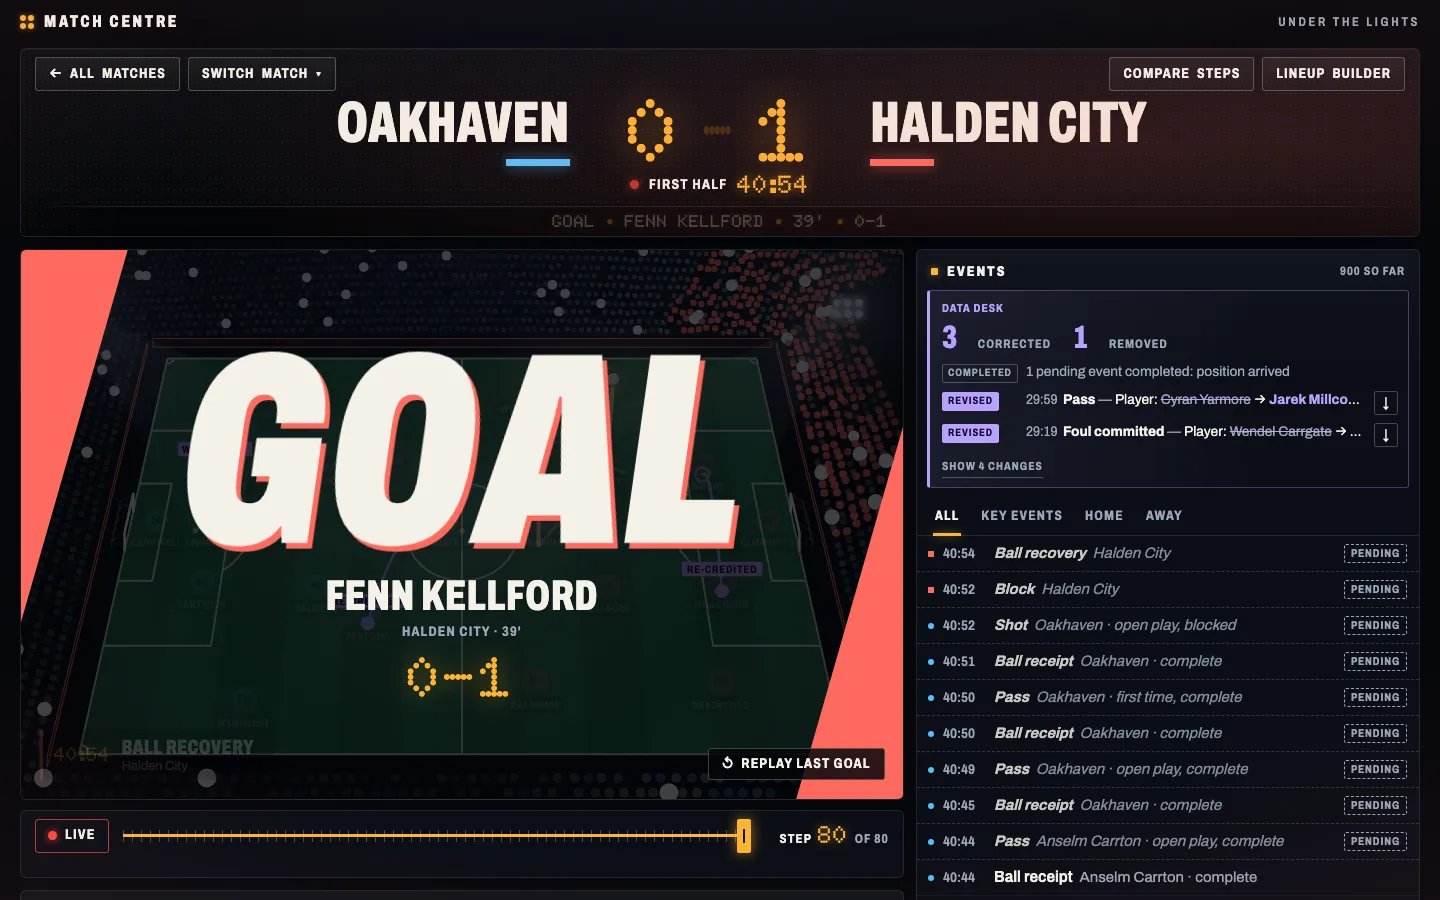
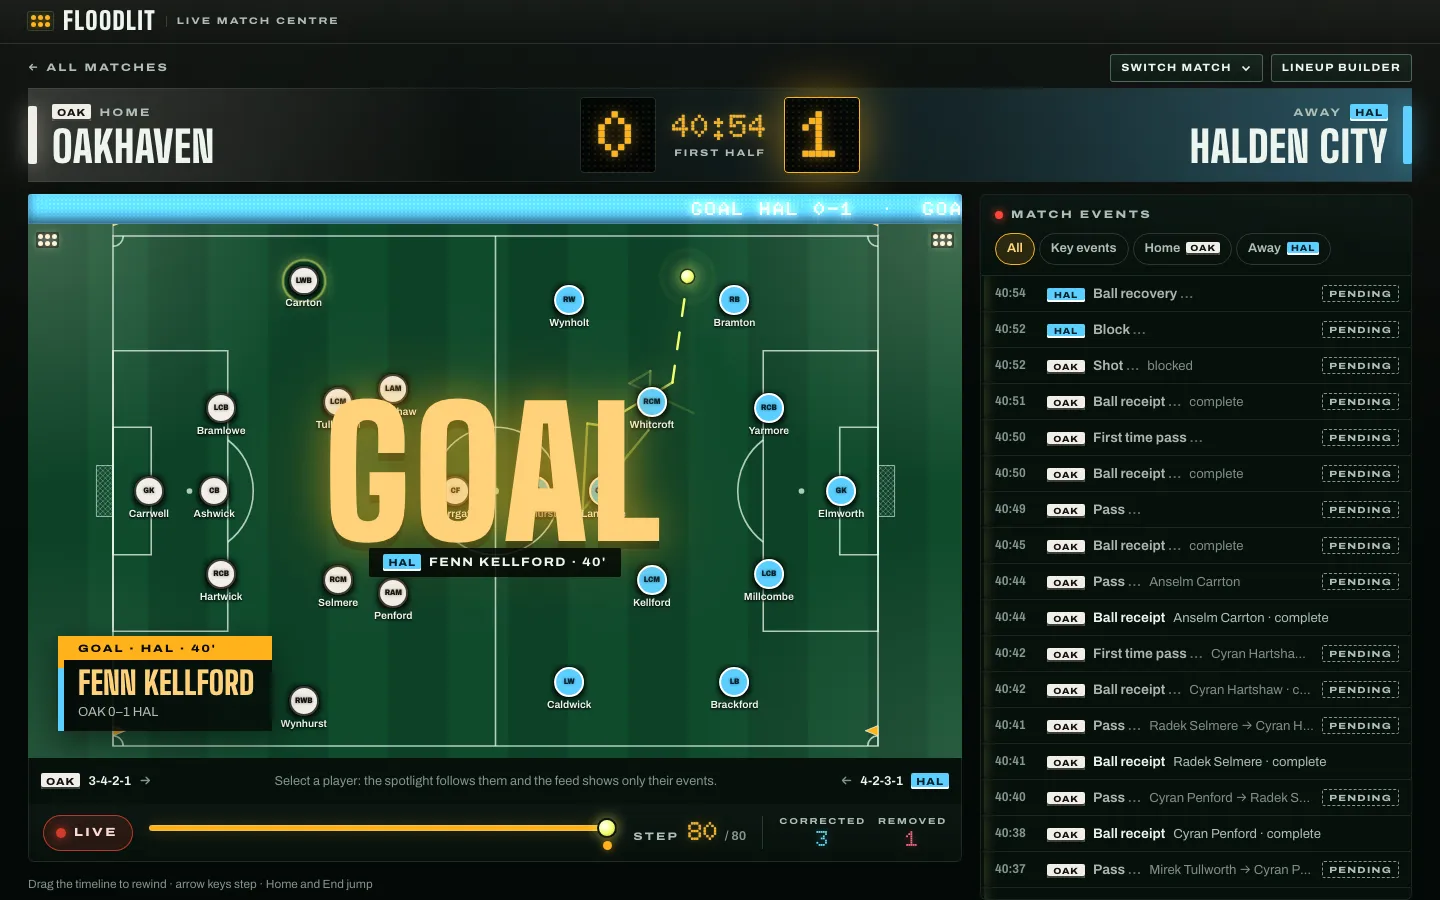
Le même but dans les deux apps.
Je ne me prononce pas sur celle qui est la plus belle.
#Fable en max
La première objection à tout cela est évidente : vous avez comparé high et max. J’ai donc lancé Fable une fois en effort max, seul, sur les deux manches. Une seule exécution, et chaotique, donc considérez-la comme un point de données isolé. Son coût est une borne inférieure, car l’une des deux requêtes de compaction manque dans la transcription.
Les deux manches ensemble, les trois exécutions
Une exécution par colonne. Fable max est une exécution annexe isolée ; son coût est une borne inférieure. Tâches longues : sur 30 mises à jour en direct de l’app de la manche 2. Étapes humaines : au-delà des deux prompts de départ.
| Les deux manches ensemble | Fable high | Opus max | Fable max |
|---|---|---|---|
| Temps (minutes) | 107 | 167 | 356 |
| Coût au prix catalogue | $59.67 | $90.13 | au moins $202 |
| Tests cachés, à chaque manche | 50 / 1 / 9 | 50 / 1 / 9 | 50 / 1 / 9 |
| Lignes de code source après la manche 2 | 12,043 | 12,302 | 17,273 |
| Tests propres après la manche 2 | 101 unitaires | 123 unitaires | 243 unitaires + 56 dans un navigateur |
| Tâches longues | 13 à 16 | 0 | 0 |
| Étapes humaines supplémentaires | 0 | 1 | 4 |
Les deux premières colonnes sont en temps réel, attentes décrites plus haut comprises. Dans la colonne Fable max, j’ai retiré les heures passées à m’attendre.
Plus de trois fois le temps et l’argent de Fable high, et les tests cachés tombent sur le même chiffre. Encore.
Il n’a commis aucune des deux erreurs ci-dessus. Il en a commis une troisième : après un changement de formation, un champ de l’outil de composition d’équipe continue d’afficher un joueur que le formulaire ne contient plus. Le bug se trouve dans un sélecteur de joueur avec recherche que seule cette exécution a construit ; les deux autres ont utilisé une simple liste déroulante. Son propre test vérifiait l’état du formulaire et non le texte du champ, il est donc resté vert, dans les deux manches.
Ce que l’effort supplémentaire a acheté se voit partout ailleurs. Des trois exécutions, c’est la seule avec ses propres tests de navigateur, y compris des vérifications d’accessibilité, la gestion du clavier et un écran de la taille d’un téléphone. Les 243 tests unitaires et les 56 vérifications de navigateur sont tous passés quand je les ai lancés, exactement comme l’annonçait son rapport final. Il a aussi passé une longue partie de la manche 2 à profiler sa propre refonte, et l’app finale ne montre aucune tâche longue dans ma mesure.
Il a aussi rempli sa fenêtre de contexte, une fois dans chaque manche. La dernière requête avant l’arrêt de la session faisait 975,193 tokens en manche 1 et 973,938 en manche 2, pour une limite d’1 million. Les deux fois, j’ai dû compacter la session et taper continue, et c’est de là que viennent les quatre étapes supplémentaires. À titre de comparaison, la plus grosse requête de Fable high faisait 645 mille tokens et celle d’Opus max 800 mille.
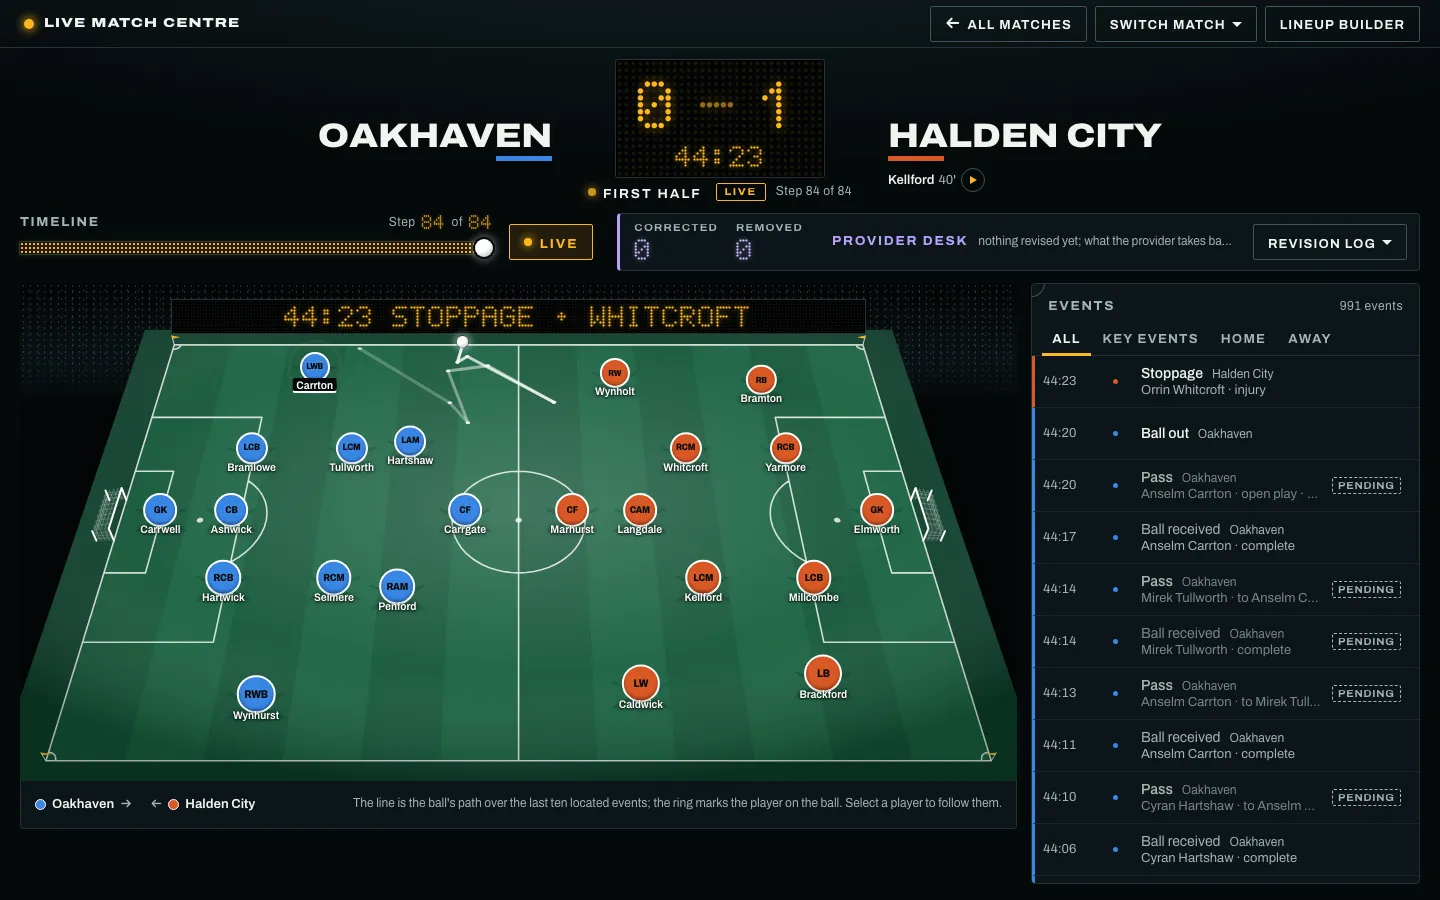
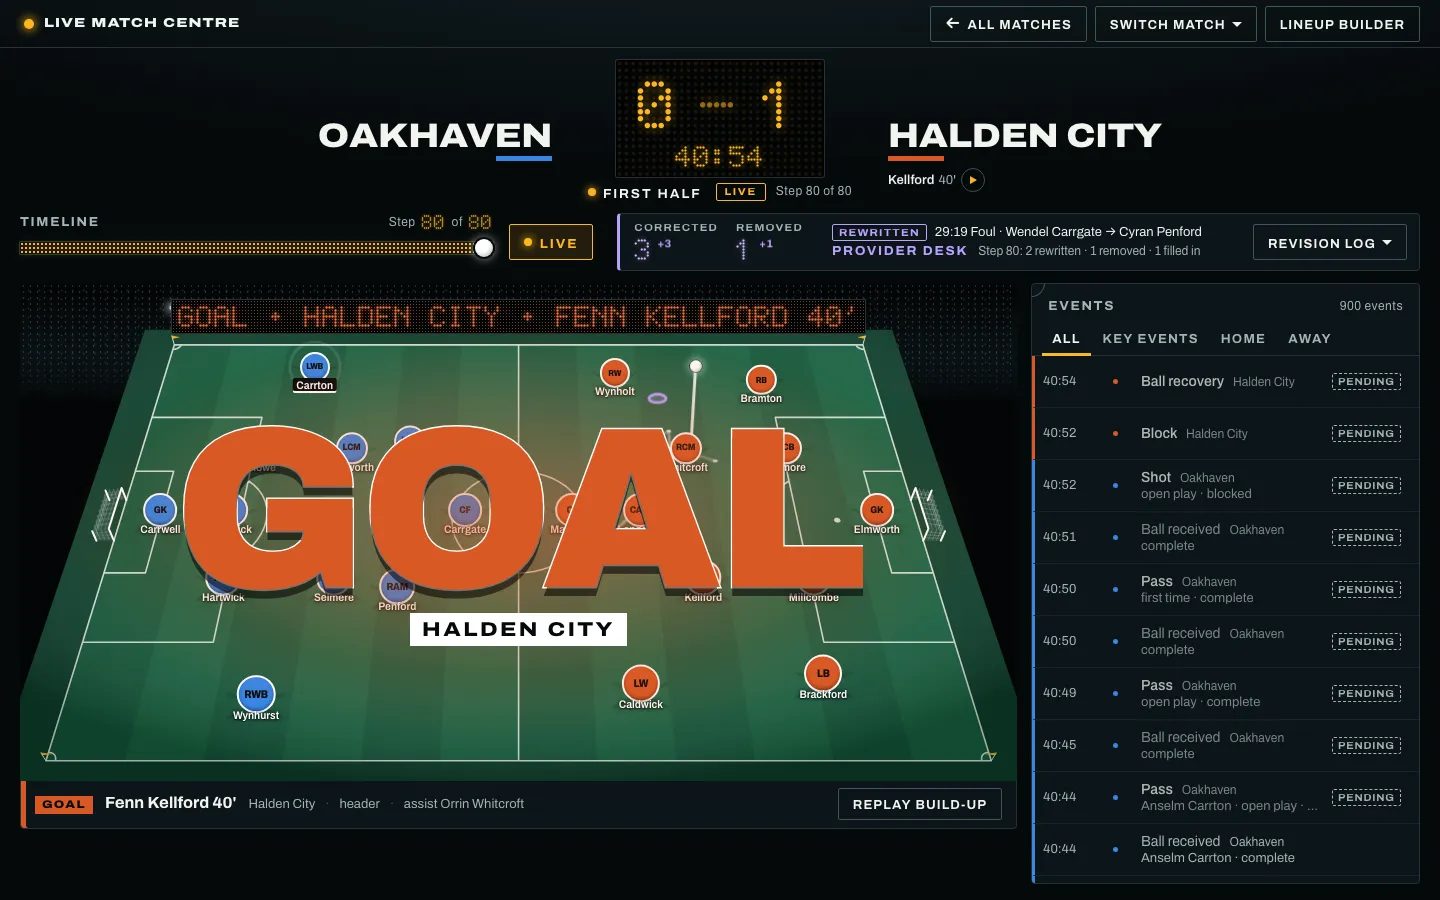
Fable max, manche 2 : la vue du match et le même but.
Plus d’effort a acheté plus de tests, plus de travail d’accessibilité et plus de code. Sur ma suite, il n’a pas acheté un meilleur score... ce qui en dit autant sur ma suite que sur le modèle.
#Lire le code
Les tests cachés regardent les apps de l’extérieur. Pour l’intérieur, j’ai utilisé trois lecteurs à l’aveugle de plus : un agent en lecture seule par app finale, les mêmes douze questions, sans noms de modèles. Ils n’ont rien exécuté ; là où une affirmation comptait, je l’ai vérifiée avec un script ou une sonde. Cela reste une exécution par modèle, donc lisez chaque différence ci-dessous comme « cette exécution », pas « ce modèle ». Fable max a aussi écrit environ 40% de code de plus que les deux autres.
D’abord les réponses courtes :
Réponses courtes issues de la lecture du code
Comptées par script dans les apps finales, tests exclus.
| Fable high | Opus max | Fable max | |
|---|---|---|---|
| Bibliothèque de store (NgRx et consorts) | aucune | aucune | aucune |
ngOnDestroy | 0 | 0 | 0 |
DestroyRef.onDestroy | 6 | 10 | 14 |
Appels .subscribe( manuels | 6 | 5 | 6 |
| …imbriqués dans un autre subscribe | 2 | 0 | 0 |
takeUntilDestroyed | 0 | 0 | 0 |
catchError dans un pipe | 0 | 0 | 1 |
| Défauts de nettoyage trouvés | 0 | 0 | 1, confirmé à l’exécution |
| Web worker pour le flux | non | oui | oui |
| Tests propres, tous verts | 101 | 123 | 243 + 56 dans un navigateur |
Dossiers et noms
Les trois ont abouti aux trois mêmes couches : la logique pure en bas, les briques partagées, les fonctionnalités en haut. Dans aucune d’elles la couche du bas n’importe vers le haut.
Fable high               Opus max                 Fable max
src/app/                 src/app/                 src/app/
├─ domain/        12     ├─ domain/        12     ├─ core/           28
├─ core/           2     ├─ data/           5     │  ├─ api/
├─ shared/         6     ├─ shared/         4     │  ├─ feed/
├─ match/         36     ├─ match/         34     │  ├─ feed-worker/
│  └─ stats/             │  ├─ compare/           │  ├─ live/
├─ match-list/     4     │  ├─ stage/             │  ├─ stage/
├─ lineup/         3     │  └─ stats/             │  └─ stats/
└─ compare/        3     ├─ match-list/     4     ├─ features/       39
                         └─ lineup/         3     │  ├─ match/
                                                  │  ├─ match-list/
                                                  │  ├─ lineup/
                                                  │  └─ not-found/
                                                  └─ shared/          8
Les nombres sont des fichiers par dossier de premier niveau, tests exclus ; les dossiers sont listés en commençant par la couche du bas, pas par ordre alphabétique.
Fable max est le plus finement découpé en bas et a les plus gros fichiers en haut. 30 de ses 32 composants gardent le template dans le fichier .ts, et 28 le CSS aussi, si bien que 12 fichiers dépassent 400 lignes là où les deux autres en ont 2 chacun. C’est aussi lui qui a le seul import d’une fonctionnalité vers une autre.
Le nommage suit partout le style maison d’Angular 22 : match-session.ts sans suffixe de type, des noms de classes sans suffixe, des sélecteurs app-. Les lecteurs ont trouvé des écarts dans chaque app. Fable high a quatre noms pour une même chose, un événement retiré : removed, withdrawn, gone et Tombstone. Opus max utilise le même nom pour une interface et un composant, si bien que l’un des deux doit être renommé à l’import. Et dans Fable max, « replay » désigne deux choses différentes.
Pas de bibliothèque de store, trois stores faits main
Personne n’a eu recours à NgRx ni à une autre bibliothèque de store. Les trois ont écrit une classe d’état à base de signals que fournit la vue du match, si bien qu’elle est détruite avec la vue quand vous changez de match.
Leur différence tient à l’étanchéité de cet état :
- Fable high : un store de 883 lignes avec 15 signals dans lesquels n’importe qui peut écrire. Et ses composants y écrivent, à 5 endroits.
- Opus max : une classe de session (498 lignes) et un « broadcast director » (624 lignes), avec 29 signals publiquement modifiables à eux deux et une écriture extérieure.
- Fable max : deux classes de 386 et 299 lignes, et pas un seul signal modifiable de l’extérieur.
Il n’en faut pas plus :
// Fable max, match-session.ts
private readonly liveState = signal<LiveState | null>(null);
private readonly liveStatusState = signal<LiveStatus>('idle');
private readonly liveErrorState = signal<unknown>(null);
// …
readonly live = this.liveState.asReadonly();
readonly liveStatus = this.liveStatusState.asReadonly();
readonly liveError = this.liveErrorState.asReadonly();
Comprenez-moi bien, rendre l’état étanche n’a pas fait disparaître la complexité. Chaque app a une classe qui en sait trop... elles l’ont seulement placée à des endroits différents. Dans Fable high, c’est le store, dans Opus max le director, et dans Fable max un composant de vue de match de 663 lignes.
Le polling, de trois façons
Le cahier des charges demande une requête par seconde. Une resource se charge quand ses entrées changent ; elle n’est pas faite pour un rythme régulier. Pour le flux en direct, les trois sont donc redescendus à RxJS, et les trois l’ont fait à l’ancienne. Le subscribe à l’ancienne avec des handlers next et error est toujours là : 6 appels manuels dans Fable high, 5 dans Opus max et 6 dans Fable max, et 10 de ces 17 prennent à la fois un handler next et un handler error, comme celui ci-dessous. Autour d’eux se trouve tout ce qui accompagne ce pattern : leur propre gestion d’erreurs, des indicateurs de chargement et d’erreur positionnés à la main, la Subscription stockée dans un champ. Personne n’a utilisé takeUntilDestroyed, toSignal ni le pipe async. La seule touche moderne est la forme de l’appel : les handlers sont passés comme un seul objet observer, et non comme deux arguments séparés.
Fable high traite RxJS comme un tuyau pour le HTTP et gère lui-même le timing :
// Fable high, match-store.ts
private poll(): void {
  const id = this.id();
  if (id === null || this.destroyed) return;
  const startedAt = Date.now();
  clearTimeout(this.slowTimer);
  this.slowTimer = setTimeout(() => this.feedSlow.set(true), 3 * POLL_INTERVAL_MS);
  this.pollSub = this.api.feed(id).subscribe({
    next: (response) => {
      clearTimeout(this.slowTimer);
      this.feedSlow.set(false);
      try {
        this.acceptLive(id, response);
      } catch (error) {
        this.failLive(error);
        return;
      }
      const wait = Math.max(0, POLL_INTERVAL_MS - (Date.now() - startedAt));
      this.pollTimer = setTimeout(() => this.poll(), wait);
    },
    error: (error: unknown) => this.failLive(error),
  });
}
Suivez acceptLive et, sur un chemin, il lance une deuxième souscription à lui, depuis l’intérieur de ce next. Pas imbriquée visuellement, mais imbriquée quand même. Cela arrive deux fois dans cette app, et les souscriptions imbriquées figurent sur ma propre liste des choses que je signale en revue de code.
Opus max laisse les opérateurs s’occuper de la planification :
// Opus max, match-session.ts
private startLive(): void {
  this.liveSub?.unsubscribe();
  this.liveStatus.set(this.live() ? 'ready' : 'loading');
  this.liveError.set(null);
  // exhaustMap: one request at a time, started on the next whole second after the previous one.
  this.liveSub = timer(0, POLL_INTERVAL_MS)
    .pipe(exhaustMap(() => this.pollOnce()))
    .subscribe({ error: (error: unknown) => this.onLiveError(error) });
}
Fable max construit « une requête, puis attendre le reste de la seconde, puis recommencer » avec defer, concat et repeat :
// Fable max, live-feed.ts
return defer(() => {
  const started = Date.now();
  const rest = defer(() =>
    timer(Math.max(0, POLL_INTERVAL_MS - (Date.now() - started))),
  ).pipe(ignoreElements());
  return concat(once(), rest);
}).pipe(
  repeat(),
  finalize(() => {
    if (channel !== null) this.decoding.release(channel);
  }),
);
C’est aussi le seul à avoir écrit le polling une seule fois. Il vit dans un service partagé par lequel la vue du match et la liste des matchs font toutes deux leur polling, et l’outil de comparaison y lit des étapes isolées. Les deux autres ont écrit leur polling deux fois, une pour le match et une pour la liste.
catchError n’apparaît qu’une seule fois dans les trois apps, et c’est dans Fable max. Fable high et Opus max gèrent chaque échec dans le callback error du subscribe. Fable max fait de même pour son polling, mais dans le curseur de navigation il intercepte à l’intérieur du pipe :
// Fable max, match-session.ts
// Turned into state here, so that the stream of scrub requests itself stays alive.
catchError((error: unknown) => {
  this.onScrubFailure(target, error);
  return EMPTY;
}),
C’est l’endroit classique pour le faire : l’erreur est gérée sur la requête interne, donc une étape en échec ne met pas fin au flux extérieur des requêtes de navigation.
Nettoyage : DestroyRef dans le constructeur
ngOnDestroy n’apparaît pas une seule fois dans les trois apps. Tous les constructeurs de composants et de services sont sans paramètres, les dépendances viennent d’inject(), et le nettoyage est enregistré via DestroyRef : 6, 10 et 14 fois. Les grosses classes d’état le font dans le constructeur. Les éléments plus petits l’enregistrent à l’endroit même où le listener ou l’observer est créé, dans un callback afterNextRender ou dans une fonction utilitaire.
// Fable high, match-store.ts
constructor() {
  inject(DestroyRef).onDestroy(() => {
    this.destroyed = true;
    this.pollSub?.unsubscribe();
    this.markerSub?.unsubscribe();
    this.scrubSub?.unsubscribe();
    clearTimeout(this.pollTimer);
    clearTimeout(this.slowTimer);
    clearTimeout(this.restTimer);
    clearTimeout(this.goalTimer);
    clearTimeout(this.phaseTimer);
    for (const timer of this.expiryTimers) clearTimeout(timer);
  });
}
// Opus max, match-session.ts
constructor() {
this.destroyRef.onDestroy(() => {
this.destroyed = true;
this.liveSub?.unsubscribe();
this.historySub?.unsubscribe();
if (this.settleTimer) clearTimeout(this.settleTimer);
if (this.leaveTimer) clearTimeout(this.leaveTimer);
});
}// Opus max, feed-processor.ts: the service that owns the web worker
constructor() {
inject(DestroyRef).onDestroy(() => this.worker?.terminate());
}J’aime la façon dont cela se lit : un seul endroit, qui ressemble à une checklist. Mais cela a la même faiblesse que ngOnDestroy a toujours eue. La checklist est tenue à la main, et ce que vous oubliez n’y figure tout simplement pas.
Fable max le montre exactement :
// Fable max, match-session.ts
constructor() {
  this.scrubRequests
    .pipe(
      switchMap(({ target, immediately }) => {
        if (target === null) return EMPTY;
        return timer(immediately ? 0 : SCRUB_REST_MS).pipe(
          switchMap(() => this.loadStep(target)),
        );
      }),
    )
    .subscribe();

  inject(DestroyRef).onDestroy(() => {
    this.destroyed = true;
    this.polling?.unsubscribe();
    this.scrubRequests.complete();
    this.pulseSubject.complete();
    this.restartSubject.complete();
    this.returnSubject.complete();
    if (this.watchdog !== null) clearInterval(this.watchdog);
  });
}
Regardez la première instruction : une souscription dont personne ne garde la référence. À la destruction, la classe complète scrubRequests, ce qui arrête les nouvelles valeurs, mais n’annule pas un timer déjà en cours à l’intérieur du switchMap. Déplacez donc le curseur, quittez le match dans le quart de seconde, et l’app envoie quand même la requête pour cette étape, au nom d’une vue qui n’existe plus.
Le lecteur l’a signalé à partir du code, et je suis allé le tester :
- Naviguer, puis quitter : Fable max a envoyé la requête tardive 6 fois sur 6, environ 250 ms après la sortie. Fable high et Opus max, 0 sur 6.
- Naviguer, puis rester (le témoin) : les trois envoient la requête, 3 sur 3, donc la sonde a bien déplacé le curseur dans chaque app.
C’est une requête gaspillée et rien ne s’accumule, donc je ne parle pas de fuite mémoire ; je n’ai pas du tout mesuré la mémoire. Mais le propre commentaire de la classe affirme que les requêtes en cours sont annulées, et son test vérifie seulement que le polling s’arrête. takeUntilDestroyed() est l’outil classique pour exactement cette ligne, et aucune des trois apps ne l’utilise.
Les lecteurs ont aussi tenu un registre de tout ce qui survit à un appel de fonction (souscriptions, timers, listeners, observers, workers, collections qui grossissent) et en ont cherché la libération : 29, 41 et 45 entrées. C’était le seul candidat. D’après leur lecture, aucune collection ne grossit à chaque polling dans aucune des apps.
Le nouvel Angular, en pratique
Points d’appel dans le code des apps, tests exclus :
Nouvelles fonctionnalités d’Angular, points d’appel
Comptés par script dans le code des apps, tests exclus.
| Fable high | Opus max | Fable max | |
|---|---|---|---|
httpResource | 5 | 3 | 1, dans un utilitaire partagé |
resource / rxResource | 0 / 0 | 0 / 0 | 1 / 1 |
linkedSignal | 1 | 2 | 9 |
effect / afterRenderEffect | 7 / 0 | 9 / 0 | 3 / 4 |
Blocs @defer | 4 | 2 | 0 |
@let | 17 | 1 | 0 |
asReadonly() | 4 | 0 | 17 |
| Signal form | 1 | 1 | 1 |
@Service() / @Injectable() | 3 / 0 | 3 / 3 | 9 / 0 |
D’après le décompte des lecteurs, 4 des 7 effects de Fable high et 6 des 9 d’Opus max écrivent dans un signal ; aucun des 7 de Fable max ne le fait de manière synchrone.
linkedSignal est celui qui m’intriguait le plus. Voici la forme simple, un état qui suit autre chose jusqu’à ce que l’utilisateur le modifie :
// Opus max, pass-network.ts
/** Follows the selected player's team; the toggle can override it. */
protected readonly side = linkedSignal<TeamSide>(() => {
  const id = this.session.selectedPlayerId();
  return (id !== null ? this.session.squadData()?.byId.get(id)?.side : undefined) ?? 'home';
});
Et la forme avec previous, utilisée ici pour décider si la liste d’événements doit animer un changement ou basculer en silence :
// Fable high, event-list.ts
protected readonly rendered = linkedSignal<
  { rows: readonly FeedRow[]; key: number | null },
  Rendered
>({
  source: () => ({ rows: this.filtered(), key: this.store.selectedPlayerId() }),
  computation: (source, previous) => ({
    rows: source.rows,
    quiet:
      !previous ||
      previous.source.key !== source.key ||
      churn(previous.source.rows, source.rows) > ANIMATE_LIMIT,
  }),
});
Les signal forms, avec une vérification du nom côté serveur qui attend la fin de la saisie :
// Opus max, lineup-page.ts
protected readonly lineupForm = form(this.model, (s) => {
  required(s.name, { message: 'Enter a name for the lineup.' });
  validate(s.name, ({ value }) => {
    const problem = value().trim() === '' ? null : nameProblem(value());
    return problem ? { kind: 'length', message: problem } : undefined;
  });
  // C12: checked against the server while typing, once typing has stopped for 300 ms.
  // httpResource cancels a superseded check, so a stale answer never wins.
  validateHttp(s.name, {
    request: ({ value }) => (nameProblem(value()) === null ? this.api.nameAvailableUrl(value().trim()) : undefined),
    debounce: 300,
    onSuccess: (response: unknown) =>
      isAvailable(response) ? undefined : { kind: 'taken', message: 'This name is already taken.' },
    onError: () => ({ kind: 'check-failed', message: 'The name could not be checked. Edit it to try again.' }),
  });
  // …
});
Panneaux paresseux. Fable high enveloppe chaque panneau de statistiques dans un @defer à l’intérieur d’un @boundary ; Opus max utilise aussi @defer, en deux blocs :
<!-- Fable high, match-view.html -->
@boundary {
  @defer (on viewport) {
    <app-shot-map />
  } @placeholder {
    <div class="stat__placeholder"></div>
  } @loading (minimum 150ms) {
    <div class="stat__placeholder skeleton" role="status" aria-label="Loading shot map"></div>
  } @error {
    <app-panel-error message="The shot map could not be loaded." (retry)="reloadPage()" />
  }
} @error {
  <app-panel-error (retry)="$reset()" />
}
Remarquez ce que fait Retry quand le chunk ne se charge pas... il recharge la page. Fable max n’a pas du tout utilisé @defer. Son propre commentaire en donne la raison : un bloc defer se souvient d’un chargement raté pour toute la durée de vie de la page, alors qu’un import dynamique dans une resource peut simplement être relancé. Il a donc écrit ceci, avec un IntersectionObserver qui bascule inView :
// Fable max, lazy-panel.ts
/** The panel's component class; requested once the frame has been seen. */
protected readonly code = resource({
  params: () => (this.inView() ? this.loader() : undefined),
  loader: ({ params: load }) => load(),
});
et l’état d’échec reçoit un Retry qui ne recharge que le code :
@case ('failed') {
  <app-failure-notice
    kind="panel"
    title="This panel could not be loaded."
    [detail]="describe(code.error())"
    (retry)="code.reload()"
  />
}
Plus de code pour un meilleur bouton Retry. Le compromis en vaut-il la peine ? Bonne question ; j’aurais sans doute livré le @defer.
Et rxResource, pour l’outil qui compare deux étapes du flux. Deux requêtes en parallèle, et le chargement, l’erreur et l’annulation viennent gratuitement :
// Fable max, step-compare.ts
protected readonly result = rxResource({
  params: () => this.request() ?? undefined,
  stream: ({ params }) =>
    forkJoin({ first: this.load(params.first), second: this.load(params.second) }),
});
Fable high et Opus max ont écrit cette même comparaison avec un subscribe manuel et leurs propres indicateurs.
Choix de performance
- Fable high traite chaque nouvelle étape sur le thread principal et construit à chaque fois un nouvel objet de ligne pour chaque événement. Cela correspond aux tâches longues que j’ai mesurées plus haut.
- Opus max parse dans un web worker, ignore une réponse dont le hash n’a pas changé et conserve l’objet d’un événement inchangé, mais reconstruit quand même toutes les lignes.
- Fable max travaille aussi dans un worker, n’envoie que les différences et ne reconstruit que les lignes qui ont changé. Le lecteur a toutefois repéré une répétition : sa fonction de résumé s’exécute trois fois sur le thread principal pour chaque étape dont les événements ont changé.
- Aucun n’utilise le défilement virtuel. Les trois s’appuient sur
content-visibility: autopour la longue liste.
Tests : ce qui est couvert, ce qui ne l’est pas
Les trois testent à fond le traitement des données (ordre, doublons, comptage des corrections, score) et la classe d’état principale avec de faux timers et du faux HTTP, jusqu’au repos de 250 ms du curseur de navigation. Ensuite, la couverture s’amenuise.
- Fable high, 101 tests dans 9 fichiers : rien n’effectue le rendu d’un composant. Le mouvement sur le terrain, le polling des cartes de match, le câblage du formulaire de composition et la page de comparaison ne sont pas testés.
- Opus max, 123 tests dans 13 fichiers : un seul test avec rendu, le formulaire de composition. Le director de 624 lignes n’a aucun test, pas plus que le chemin du worker.
- Fable max, 243 tests dans 17 fichiers, plus 56 vérifications de navigateur : les composants et l’une de ses deux classes d’état ne sont atteints que par les vérifications de navigateur. Celles-ci comparent l’écran à des attentes calculées à partir des enregistrements, et non du code de l’app, et elles incluent le clavier, l’accessibilité et les chemins d’échec.
Et voici la partie gênante : aucune des trois suites n’a détecté l’unique échec que mes tests cachés ont trouvé dans la même app. Pas même celle aux 299 vérifications.
Un junior pourrait-il suivre ?
Trois sondes de lisibilité
Décomptes des lecteurs à l’aveugle, un lecteur par app. Fichiers pour suivre un polling : de l’appel HTTP à un joueur qui se déplace sur le terrain.
| Sonde | Fable high | Opus max | Fable max |
|---|---|---|---|
| Fichiers pour suivre un polling | 15 | 12 | 17 |
| Fichiers pour un nouveau panneau de statistiques | 5 | 3 | 4 |
| Fonction la plus longue | 173 lignes | 179 lignes | 129 lignes |
Ces trois lignes sont les décomptes des lecteurs. J’ai aussi demandé à chaque lecteur des notes de 1 à 5, avec des repères fixes, pour qu’un chiffre veuille dire quelque chose :
- Lisible pour un junior (un an d’Angular) : 1 signifie qu’il ne peut pas suivre le flux de données principal sans aide. 3 signifie qu’il peut le suivre avec effort, et que plusieurs fichiers demandent l’explication d’un senior. 5 signifie qu’il peut suivre un polling de l’appel HTTP jusqu’au terrain seul, en une heure.
- Lisible pour un senior : 1 signifie se battre avec le code. 3 signifie correct, mais avec des surprises. 5 signifie aucune surprise, et il approuverait la structure en revue.
- Extensibilité : 1 signifie que chaque changement touche une classe géante. 3 signifie qu’un changement courant touche de 3 à 5 fichiers et qu’il y a un point chaud. 5 signifie que les changements restent locaux.
Les trois apps ont obtenu les mêmes notes : 3 pour un junior, 4 pour un senior et 3 pour l’extensibilité. Concrètement, un junior peut s’y retrouver dans n’importe laquelle, mais pas seul ; un senior les lit confortablement et rencontre quand même quelques surprises. Les notes viennent de trois lecteurs différents, donc un écart d’un point n’importe où relève du bruit.
Ce qui arrête un junior diffère dans chacune : le store de 883 lignes dans Fable high, le worker et le director dans Opus max, et dans Fable max simplement le nombre de fichiers, plus un worker qui parle son propre protocole de deltas. Les commentaires aident dans les trois. Ils expliquent surtout le pourquoi, pas le quoi.
Ma lecture de cette lecture : les trois apps sont au même niveau. L’effort supplémentaire de Fable max se traduit par un état étanche, un polling écrit une seule fois et beaucoup plus de tests. La même exécution a produit le seul défaut de nettoyage confirmé et le chemin le plus long à travers le code. Plus de code ne s’est pas traduit par un code plus facile à suivre.
#Ce qui a mal tourné de mon côté
Je me suis trompé sur plusieurs points, et je pense que c’est la partie la plus utile de tout ceci.
- Mes tests se sont trompés six fois. Lors de la première notation, quatre tests cachés ont échoué sur les deux apps pilotes, avec des chiffres identiques. Les quatre étaient la faute de mes tests. En manche 2, deux de plus. Si je n’avais pas lu les échecs, j’aurais noté les deux modèles à 92% alors que la vérité était 100%.
- Un concurrent a vu ce que les juges avaient manqué. Les données contiennent des ids d’événements en double au sein d’un même instantané. Opus l’a remarqué et l’a géré. Ma réponse de référence, non, et elle a fait échouer les deux apps pour cela.
- Ma configuration « propre » ne l’était pas. Dans le pilote, mon fichier d’instructions global se chargeait dans chaque session malgré l’option censée l’exclure. Je l’ai découvert en lisant les transcriptions, pas en interrogeant le modèle.
- Les dossiers n’isolent pas les ports. En manche 2, les deux exécutions parallèles ont choisi le même port de débogage Chrome évident et ont partagé un navigateur pendant une demi-heure. Chacune a entrevu la page de l’autre : quelques centaines de caractères de HTML dans un sens, un log dans l’autre. Les deux l’ont remarqué en moins d’une minute et ont changé. Les concepts étaient déjà écrits à ce moment-là, et rien n’a été repris... mais c’est arrivé.
- Les dossiers n’isolent pas non plus les processus. Chaque exécution arrêtait ses serveurs par leur nom. Dans la paire propre, le nettoyage d’Opus a une fois arrêté aussi le serveur de dev de Fable, parce que les deux scripts de démarrage portaient le même nom de fichier. Fable l’a relancé en quelques secondes et a mis cela sur le compte de ses propres fichiers à moitié modifiés. Les exécutions pilotes utilisaient le même genre de commande côte à côte, et je ne les ai pas vérifiées sur ce point.
- Mes chiffres en direct étaient faux. Pendant les exécutions, je comptais les lignes de transcription comme des messages et j’ai annoncé 234 et 669 là où les vrais chiffres sont 99 et 227.
La solution aux deux fuites est sans surprise : lancer les agents l’un après l’autre, ou donner à chacun son propre conteneur. C’est ce que je ferai la prochaine fois.
#Ce que cela ne vous dit pas
- Une seule paire propre, une exécution par modèle. Cela ne dit rien de la variance, et les détails inversés entre le pilote et la paire propre montrent combien elle est grande.
- La suite cachée est à son plafond. Elle trouve des bugs ; elle ne peut pas classer ces deux-là.
- La lecture du code reste une lecture. À part la sonde et la suite de tests propre à chaque app, rien n’y a été exécuté, et je n’ai mesuré aucune mémoire. « Aucune fuite trouvée » signifie que trois lecteurs n’en ont pas vu.
- Les deux modèles ne reçoivent pas exactement le même prompt système de l’outil, et je ne peux pas compenser cela.
- Les outils de notation et la comparaison du code ont été construits avec l’aide de Fable. Les décisions d’appréciation ont été lues à l’aveugle et demandent une signature humaine, qui est la mienne.
- Les données des matchs sont sous licence, il n’y a donc pas de dépôt public. La démo tourne sur les mêmes enregistrements, avec chaque id, nom et date remplacés.
#Mon avis
Fable high est mon choix pour ce type de travail. Le même score sur mes tests, en environ deux tiers du temps et pour environ deux tiers de l’argent. Opus max est le collègue le plus soigneux : il a lu la page d’aide en premier, il a laissé le commentaire au niveau du piège, il a commandé sa propre revue de code. Comprenez-moi bien, aucun des deux n’est parfait. Chacun a livré exactement une chose que mes tests ont détectée, et les deux m’ont affirmé dans leur rapport final que tout était terminé. La lecture du code n’a pas non plus changé mon choix : les trois bases de code sont au même niveau. Celle de Fable high est la plus petite et la plus simple, avec un store dans lequel ses composants écrivent directement, et à ce prix-là, je peux m’en accommoder.
Gardez une chose à l’esprit en lisant la partie sur le code : tout cela s’est fait sans instructions de ma part. Personne n’a dit aux modèles comment organiser les dossiers, comment construire les composants, ni si template, styles et logique doivent tenir dans un fichier ou dans trois. Ils avaient le cahier des charges et la skill Angular officielle, et chacun de ces choix était le leur. C’est aussi la bonne nouvelle concernant ce qui reste à reprendre. Un subscribe manuel ici, un composant de 663 lignes là, du CSS dans le fichier .ts... ce sont exactement les choses que quelques lignes d’instructions changent. Cette dernière partie vient de mon expérience au travail, pas de quelque chose que ce test a mesuré.
Et à ma surprise, avec la skill Angular sous la main, ces modèles travaillent vraiment, vraiment bien avec Angular 22. Ils ne devinent pas. Le linkedSignal qui regarde sa valeur précédente, la raison écrite noir sur blanc pour se passer de @defer, le commentaire à côté d’exhaustMap... ils savent à quoi sert chaque outil, et ils savent s’en servir.
Ce à quoi je ne m’attendais pas, c’est à quel point le choix entre les deux modèles a peu compté à côté du choix de la manière de les mesurer. Les modèles ont construit l’app en une heure ou deux. Arriver à des chiffres auxquels je me fie m’a pris des jours.